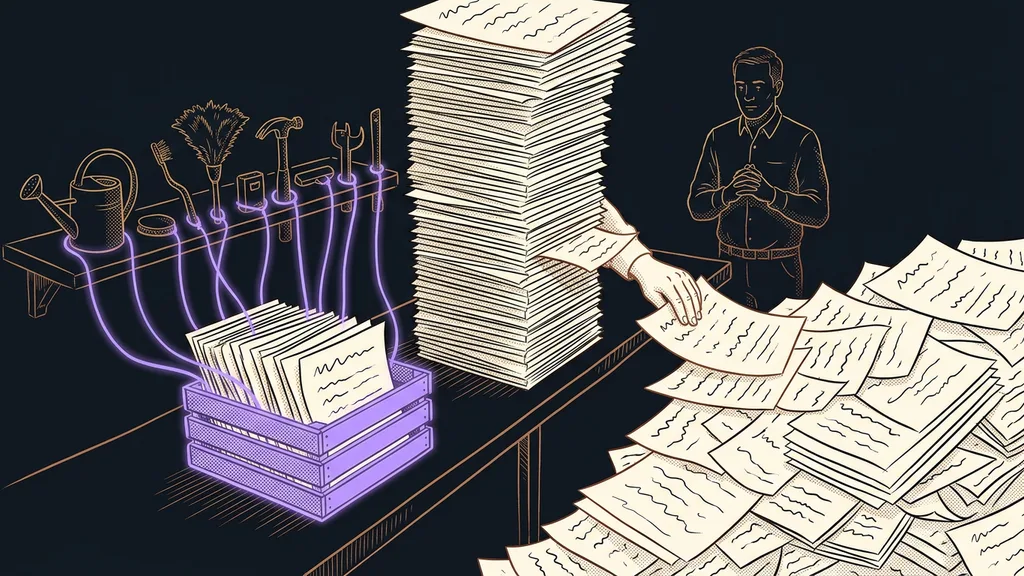
Nejhorší práce s dokumenty není čtení. Je to otevírání. Představte si složku s několika sty smlouvami, ze kterých potřebujete tři údaje: datum, částku a výpovědní lhůtu. Samotné čtení jedné smlouvy zabere minutu. Zbytek odpoledne pak sežere klikání, hledání a přepisování do tabulky.
Slyším to od účetních kanceláří i od lidí, kteří spravují smlouvy. Otevřít soubor, najít částku, přepsat ji do tabulky, zavřít. A tak pořád dokola. Není to těžká práce, je to práce, u které se po hodině přestane dávat pozor. A právě tam vznikají chyby, kterých si nikdo nevšimne.
Problém není ve čtení, ale v otevírání
Každý jednotlivý soubor je snadný. Těžké je zvládnout jich dvě stě za sebou a u posledního být stejně pozorný jako u prvního.
Dávkové čtení
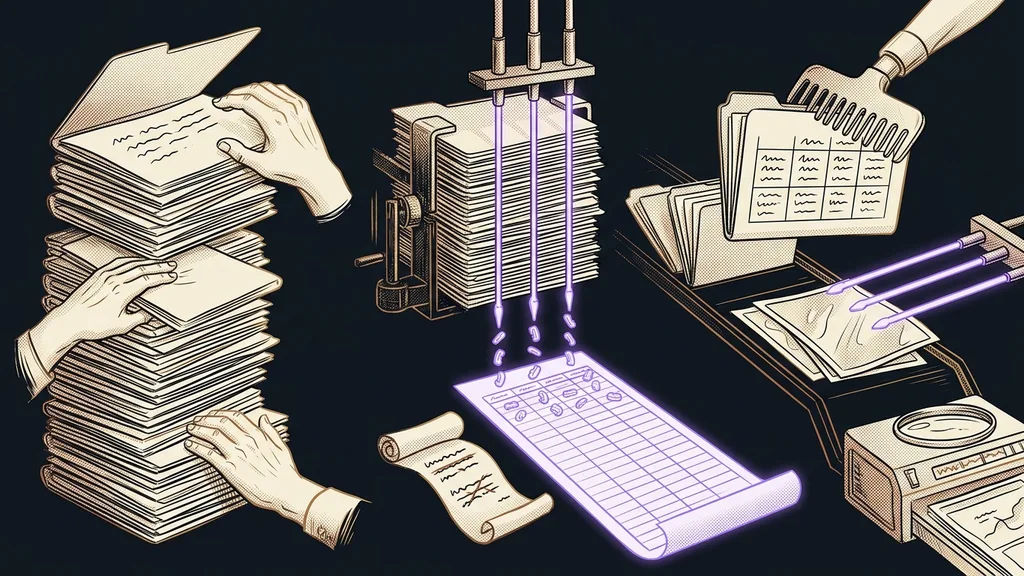
Postup, při kterém se celá složka dokumentů zpracuje najednou podle jednoho zadání. Neptáte se na jeden soubor, ale rovnou na všechny: vytáhni z každé smlouvy datum, částku a lhůtu. Výstupem není odpověď v okně, ale tabulka s jedním řádkem na dokument.
Rozdíl je hlavně v tom, co po práci zbude. Ruční čtení nechá hotovou tabulku a unaveného člověka. Dávka nechá tutéž tabulku a odpoledne, které se dá dát někam jinam.
O kvalitě výsledku přitom nerozhoduje počet souborů, ale zadání. Čím přesněji řeknete, co má z dokumentu vypadnout, tím míň se potom opravuje. Rozdíl mezi žádostí o důležité údaje a žádostí o datum podpisu, celkovou částku bez daně a výpovědní lhůtu ve dnech je propastný. První vrátí odpověď, druhá vrátí tabulku.
Otevřít dvě stě souborů umí každý. Umění je nemuset otevřít ani jeden.
Tabulka uvnitř dokumentu je jiná práce než odstavec
Odstavec se čte zleva doprava a nic se nemůže stát. U tabulky záleží na tom, kde hodnota na stránce leží, a přesně tam začínají potíže.
Faktura má popisek v jednom sloupci a číslo ve druhém. Když se čtení splete jen o kousek, přiřadí částku k jinému řádku. Výsledek pak vypadá naprosto věrohodně, jenom je špatně, a to je horší než prázdné pole. Prázdného pole si někdo všimne, věrohodného čísla ne.
Nejhůř na tom bývají dokumenty s grafickým vzhledem: nabídky, výkazy a prezentace s postranními sloupci a barevnými boxy. Tam se vyplatí výsledek prohlédnout pokaždé, i když u obyčejných smluv vychází dávka bez jediné chyby. Opačný směr je mimochodem mnohem snazší. Když dokument teprve vzniká, z formuláře vypadne hotové PDF a přepisovat se nemusí nic.
Co z toho vypadne: tabulka, ne shrnutí
Výstupem dávky nemá být souhrn ani hezky napsaný odstavec. Má to být tabulka s jedním řádkem na dokument a jedním sloupcem na údaj.
Souhrn totiž nejde zkontrolovat. Tabulku ano: otevřete pět náhodných řádků, porovnáte je s původním souborem a hned víte, jestli dávce věřit. Právě proto do ní patří i sloupec s názvem zdrojového souboru a číslem stránky. Bez nich se ověřuje těžko a při prvním sporu o číslo nemáte co ukázat.
Kontrola kvality
Po každé dávce vezměte pět náhodných řádků a porovnejte je se zdrojovým dokumentem. Když sedí všech pět, výsledku věřte. Když neprojde jediný z nich, neopravujte ten jeden řádek. Zastavte se, upřesněte zadání a pusťte celou dávku znovu.
Hotová tabulka navíc nemusí skončit v tabulkovém editoru. Když se s údaji má pracovat dál, patří rovnou do databáze, kterou si AI sama plní i čte. Pak se nad nimi dá ptát podobně, jako se dá ptát nad archivem vlastních schůzek.
Kde to naráží: sken a chybějící textová vrstva
O všem rozhoduje jediná věc. Jestli jde text v dokumentu označit myší, je práce snadná. Když se místo toho označí celá stránka jako obrázek, držíte v ruce fotku papíru.
Textová vrstva
Neviditelný text uložený pod tím, co na stránce vidíte. Poznáte ji tak, že text jde označit myší a zkopírovat. Dokumenty, které vznikly v počítači, ji mají skoro vždycky. Skeny a fotky papírů ze schránky ji nemají a text se z nich musí nejdřív rozpoznat.
U skenů se text nejdřív rozpozná z obrázku a teprve pak se čte. Výsledek bývá znatelně horší, nejvíc na háčcích a čárkách. Není to překážka, jen se počítá s tím, že se prochází víc vzorků a někdy se sáhne po lepší kopii.
Stejný přístup funguje i na data, která v žádném PDF nejsou. Když leží na cizím webu, sbírají se hromadně a bez ručního kopírování, a kontrola vzorku platí úplně stejně.
Komu se dávkové čtení nevyplatí
A komu se to nevyplatí? Kdo má pět smluv za rok, otevře si je rychleji sám, než by vysvětloval, co se z nich má vytáhnout.
Druhý případ je zrádnější. Dávka nedává smysl tam, kde na každém jednotlivém dokumentu visí rozhodnutí o penězích a kontrola se stejně musí udělat u všech. Tam se čas nešetří, jen se přesouvá z otevírání do kontrolování. Část té kontroly se dá vrátit zpátky stroji, když si výsledek po sobě sám projde dřív, než ho odevzdá. Poslední slovo ale i tak zůstává člověku.
Celé čtení v kostce
- Srovnejte dokumenty do jedné složky a zjistěte, kolik z nich jsou skeny.
- Sepište si, které údaje z každého potřebujete. Čím konkrétněji, tím lépe.
- Pusťte dávku a nechte si výstup jako tabulku, jeden řádek na dokument.
- Do tabulky si nechte přidat i název souboru a stránku, ať je co ověřovat.
- Zkontrolujte pět náhodných řádků. Jediný špatný znamená upřesnit zadání a pustit znovu.
- U dokumentů s grafickým vzhledem počítejte s kontrolou vždycky, ne jen na vzorku.
Otevřít soubor, najít částku, přepsat ji do tabulky, zavřít. Ta práce nikdy nebyla ve čtení. Byla v tom, že jste museli otevřít každý soubor zvlášť, abyste zjistili, jestli v něm vůbec něco zajímavého je. Dobré čtení dokumentů nešetří čas tím, že čte rychleji. Šetří ho tím, že přestanete otevírat soubory, ve kterých nic není.