Web odpovídá na otázky, které jste vymysleli vy. Lidé se přitom ptají jinak: jinými slovy, z jiné strany a často na něco docela jiného. Na cenu, na srovnání s konkurencí, na to, jestli to funguje i v jejich oboru. Ten rozdíl nevidíte, dokud si ho někdo nevypíše.
Sám jsem tomu dlouho nevěřil. Psal jsem na blog to, co mi přišlo důležité, a pak se divil, že to nikoho moc nebere. Když jsem si poprvé nechal vypsat, na co mě lidé v hledání nacházejí, byla polovina dotazů úplně jinde, než jsem čekal. A ty nejzajímavější z nich neměly na webu ani větu.
Lidé vás najdou. Jen na něco jiného, než čekáte
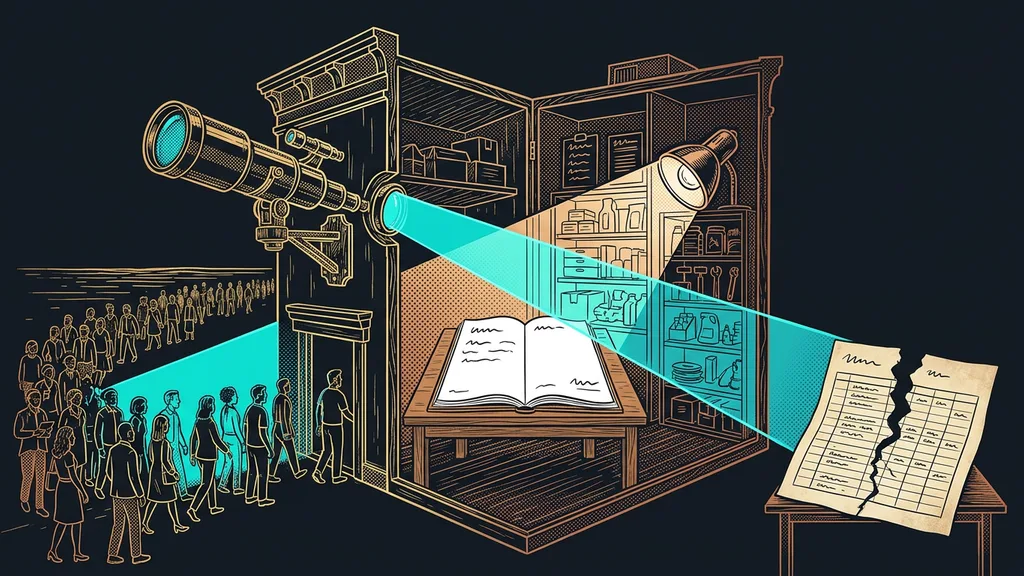
Vyhledávač vás zobrazuje i na dotazy, o kterých nemáte tušení. Nemusíte je odhadovat ani vymýšlet, protože jsou zaznamenané. Google Search Console je vede u každé adresy zvlášť: co člověk napsal, kolikrát se vaše stránka ukázala a jak často na ni klikl.
Díra se přitom pozná snadno. Na nějaký dotaz se zobrazujete pravidelně, ale kliká málokdo, protože na stránce ta odpověď vlastně není. Vyhledávač vás nabídl, člověk se podíval a šel jinam.
Němá otázka
Dotaz, na který se vám web zobrazuje, ale nemá na něj odpověď. Člověk vás uvidí ve výsledcích, klikne nebo neklikne, a odejde stejně nepoučený, jako přišel. Je to nejlevnější díra, jakou na webu můžete mít: poptávka už existuje, chybí jen text, který jí vyjde vstříc.
Nejdražší stránka na webu není ta, kterou nikdo nenajde. Je to ta, kterou lidé najdou a hned zase zavřou.
Data z vyhledávání nejsou tabulka, ale seznam přání
Každý řádek v těch datech je člověk, který něco potřeboval. Napsal to svými slovy a ze své situace. Když se na to díváte jako na tabulku, vidíte čísla. Když to čtete jako věty, vidíte poptávku.
Proto se ta data nemají exportovat, ale přeložit. Dotaz „kolik stojí crm pro malou firmu“ je ve skutečnosti strach z drahého závazku. „Gohighlevel česky“ je obava, jestli to zvládne český zákazník. „Automatizace faktur bez programátora“ je nedůvěra, že to bude složité. Tři věty, tři chybějící odstavce na webu.
Z čísel se dá udělat věta, které rozumí i majitel
Užitečný výstup není graf, ale seznam vět. Přesně tuhle práci za vás dnes odvede AI: vezme surová data o hledání, porovná je s tím, co na webu opravdu stojí, a napíše, kde se ty dvě věci míjejí. Ne jako export, ale jako poznámky, které pochopíte při kávě.
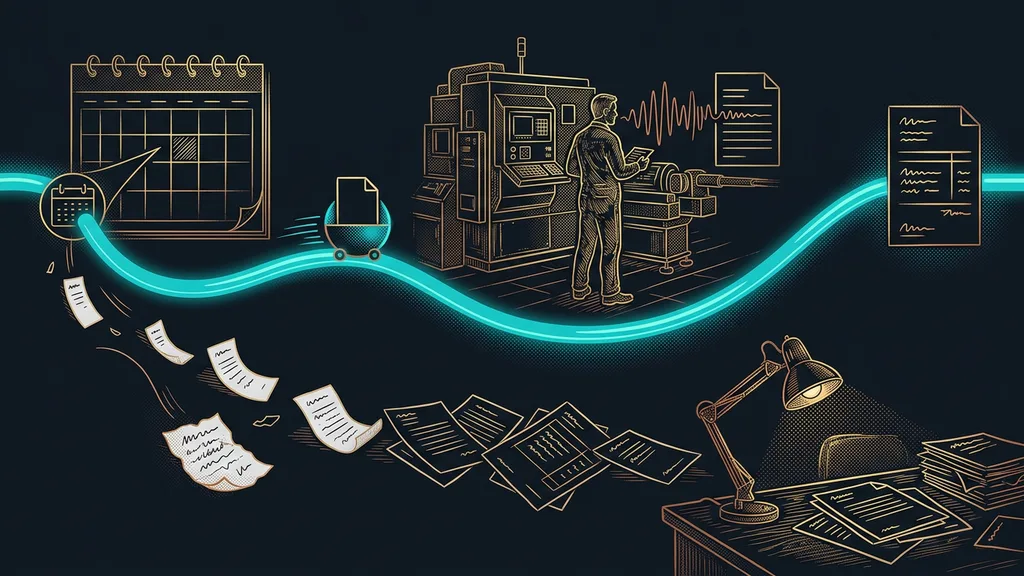
Jednorázově to nemá smysl, protože se mění dotazy i vaše stránky. Měsíční přehled, který se poskládá sám, má tu výhodu, že na něj nikdo nemusí mít čas. Přijde, i když máte plný týden.
Minutový sebetest
Napište si pět otázek, které vám klienti pokládají hned na první schůzce. Pak si každou z nich zkuste najít na vlastním webu. Kolik z nich tam má vlastní stránku nebo aspoň poctivý odstavec? U klientů, kterým weby prohlížím, to bývá jedna, výjimečně dvě.
Naplánovaná rutina
Práce, která se spustí sama v daný čas a čeká na vás hotová. Nezadáváte ji, nepřipomínáte si ji a nikdo ji nedělá ručně. U dat z vyhledávání to znamená, že si jednou za měsíc nemusíte na nic vzpomenout: přehled leží ráno na stole, i s tím, co se od minula změnilo.
Co z toho nakonec vypadne
Seznam. Nic víc z toho vyjít nemá. Položky seřazené podle dvou věcí: kolik lidí se na to ptá a jak blízko jsou ti lidé k tomu, aby něco poptali. Druhé kritérium je důležitější, protože deset lidí s penězi v ruce má větší cenu než tisíc zvědavců.
Část položek je na jeden odstavec do stránky, která už dávno existuje. Část je na nový článek. A část patří úplně jinam než do textu: když se lidé opakovaně ptají na termín nebo na cenu, stránka s formulářem a evidencí poptávky udělá víc než tisíc slov. Novou stránku k tomu dnes nasadíte jedním zadáním, takže od rozhodnutí k živé adrese je to práce na odpoledne.
Stejné otázky se navíc vracejí i jinde, než čekáte. Když je má chatbot na webu ve své knihovně odpovědí, odpoví na ně v noci i o víkendu. A ve chvíli, kdy se z celého kolečka stane pravidelný provoz, píše se obsah podle fronty témat, ne podle toho, co koho ráno napadne.
Stejně užitečná je i druhá polovina seznamu, tedy dotazy, na které odpovídat nemáte. Chodí na ně lidé, kteří hledají něco jiného a u vás by jen zklamaně odešli. Vyřadit takovou položku je plnohodnotné rozhodnutí. Ušetří vám celý článek a nepokazí stránku, která zatím funguje dobře.
Komu se to nevyplatí
Někomu se to nevyplatí, a je fér to říct. Kdo spustil web před pár týdny, nemá z čeho číst. Data vznikají z reálných zobrazení, a těch je na začátku tak málo, že by se z nich četly náhody. Prvních pár měsíců udělá víc obyčejné psaní než měření.
Nevyplatí se to ani tomu, kdo nemá v úmyslu nic dopsat. Seznam chybějících odpovědí je k ničemu, dokud se z něj nestane text na webu. Znám firmy, které mají disk plný analýz a na webu pořád tytéž tři stránky z doby, kdy začínaly.
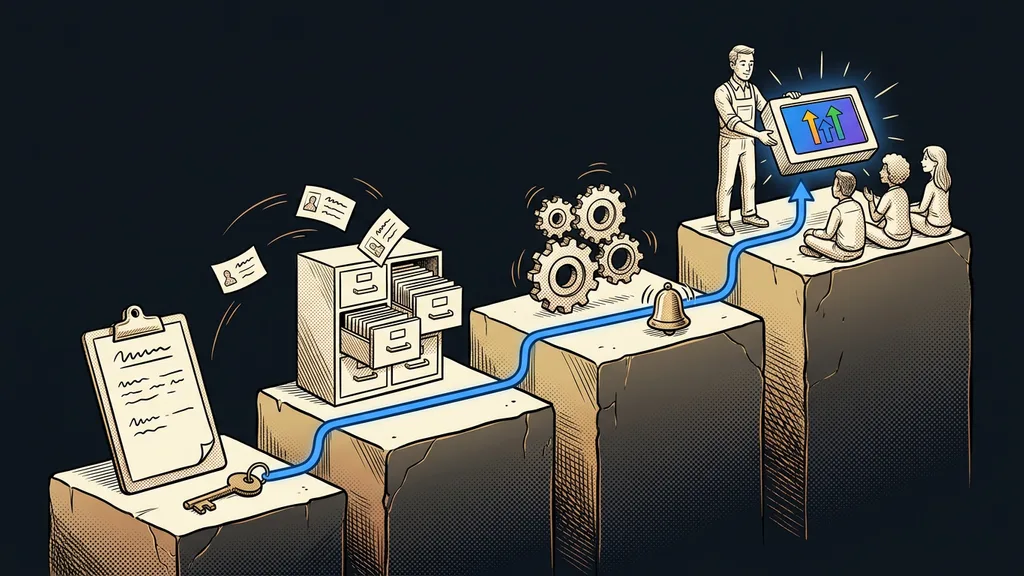
Celý postup v kostce
- Z vyhledávače se vytáhne, na které dotazy se váš web vůbec ukazuje.
- Dotazy se přeloží do lidských otázek, ne do klíčových slov.
- Ke každé otázce se přiřadí stránka, která na ni odpovídá. Nebo se poznamená, že chybí.
- Chybějící odpovědi se seřadí podle počtu tazatelů a podle blízkosti k poptávce.
- Odshora se dopisuje: odstavec, stránka, článek.
- Za měsíc se to celé zopakuje a porovná s minulým kolem.
Vzpomeňte si na tu polovinu dotazů, která byla jinde, než jsem čekal. Ten rozdíl není v tom, že byste psali špatně. Je v tom, že odpovídáte na otázky, které nikdo nepoložil. Poptávka po vašich odpovědích už existuje a někdo ji za vás zapsal. Stačí si ji přečíst a odpovědět.